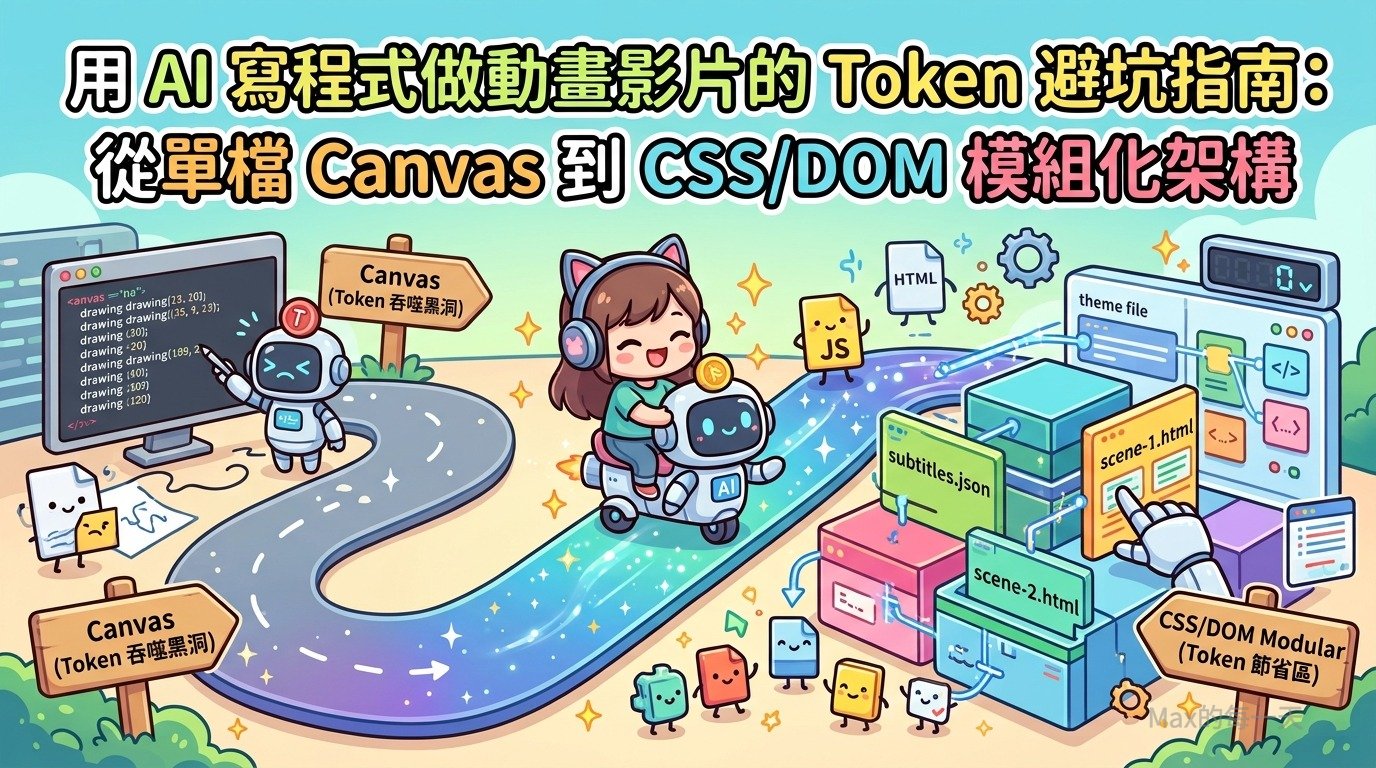
近年來,「用程式碼寫動畫,再透過 Playwright 逐格截圖渲染成 4K/60fps 影片(Code-to-Video)」的工作流逐漸成為獨立創作者與工程師的熱門利器。搭配 Cursor、Claude、ChatGPT 或 Antigravity 等 AI 程式助理,只要給出大綱與腳本,AI 幾分鐘就能為你寫出一個包含時間軸控制、字幕對位與動畫渲染的網頁。
但在實際反覆迭代、微調設計風格時,很多人會遇到一個痛點:「為什麼我只是想改場景 3 的文字顏色,或者把某個元素往上移 20px,AI 卻花費了天量的 Token,甚至因為上下文過長開始遺漏程式碼?」
本文將以真實專案經驗為出發點,分析這個「Token 吞噬黑洞」的成因,提供第三方動畫框架的完整選型評估,並給出優化後的最佳實踐架構與升級版 Prompt 範本。
一、 血淚經驗:原本的工作流與 Prompt
在製作一支主題為《別拿未來的焦慮,懲罰現在還在努力的自己》的教學動畫時,我們最初給 AI 的 Prompt 如下:
原版 Prompt
幫我製作一支教學動畫解說影片,主題是「別拿未來的焦慮,懲罰現在還在努力的自己」。
用程式逐格渲染成 MP4(HTML Canvas 的 seek(t) + Playwright 截圖 + ffmpeg),並用我的聲音配旁白。

# 一、規格
- 16:9,1920×1080,30 fps,旁白參考 file:@code-v10.md
- 字幕在畫面下方,深色膠囊底、象牙白字;字幕顯示原文(英文、數字照寫)
- 不加背景音樂;旁白會由我真人配音, 下一段字幕的顯示的觸發是按 mouse click or keyword space key.
- 直接隱藏面, 讓我可以直接錄畫面同時配音產生影片, 並要支援我使用 click or space 切換 subtitle.

# 二、旁白稿(8 段,畫面以段落為單位)
1. 段落清單:
- 別拿未來的焦慮,懲罰現在還在努力的自己。
- 一個關於焦慮的小故事
- 修好性格,成為靠得住的人
- 練好本事,別成為破水桶
- 停止內耗,掌控不了的交給上天
- 做完你能做的,剩下的就別煩惱了
- 歡迎留言分享:你最近最想卸下的內耗是什麼呢?
2. 先不要寫程式,給我六格分鏡。讓我看過、改過最後確認過,等方向對了再動手。
3. 顯示風格為 dark theme 有高級質感的簡報風格的動畫, 避免太花俏的用色, 每個場景之間要有一致性.
  目標受眾為一般民眾, 避免於 dark theme 使用太暗的前景文字, 會造成閱讀困難.
4. 渲染之前,先抽開頭、中間、結尾三格檢查,沒問題再整支輸出。
5. 避免最下面的字幕overwrite 畫面顯示的元素, 字幕上緣約在 y≈940,使所有元素都在 y≤870 以內,留有約 70px 安全距離。
二、 為什麼這個工作流程會變成「Token 吞噬黑洞」?
當 AI 依照上述提示詞生成檔案時,通常會產出一個 單一且龐大的 scene.html(長達 1,200 ~ 1,500 行),裡頭包含:
- CSS Reset 與控制面板樣式
- 預設的旁白時間軸陣列
- Playwright 逐格渲染輔助鉤子
- 錄音模式與快捷鍵邏輯
- 龐大的 Canvas 2D 命令式繪圖代碼(
drawScene1到drawScene6)
核心問題剖析:
- 單檔肥大(Monolithic File)
AI 助理每執行一次修改(例如「把文字調亮」),工具必須把這 1,300+ 行程式碼送入 Context Window。若經過 4~5 輪微調,單次對話就消耗了數萬甚至數十萬 Tokens。 - 命令式(Imperative)Canvas 繪圖對 AI 極不友善
Canvas 是像素與命令導向的:ctx.fillStyle = "rgba(148,163,184,0.7)"; ctx.fillText("能力不足,機會留不住", x, y + 200);文字、顏色、排版全寫死在 JS 運算中。當你要調整邊界或對比度時,AI 無法透過 CSS 選擇器全域修改,必須逐行用正則搜尋每條指令並手工計算座標(如y - 280 + i * 60),極易出錯且耗損算力。 - 資料、樣式、邏輯三者混雜
旁白文案、色票(Design Tokens)、場景布局和時間軸驅動全部混在一起。改動文案等於改動動態繪圖代碼。
三、 第三方框架選型評估
在決定下一步架構前,我們針對市面上常見的動畫與影片生成方案進行了深入評估:
| 方案 | 特色與優勢 | 缺點 / AI 維護成本 | 適合場景 |
|---|---|---|---|
| 原生 DOM/CSS 模組化 (強烈推薦) | 0 第三方依賴,極速啟動直接保留既有的 Playwright + ffmpeg 渲染工作流支援 CSS 變數,修改全域樣式極度省 Token宣告式 HTML/CSS,AI 解析與修改代碼成功率最高 | 不適合極其繁複的三維流體或物理碰撞粒子運算 | 首選推薦:文字講解、高級商務簡報、Motion Graphic 圖表動畫。 |
| Remotion (React) | 業界最成熟的 Code-based 影片框架支援 React 元件生態與強大的時間軸(useCurrentFrame)伺服器端確定性渲染優秀 | 專案初始化門檻高(Node.js, Webpack, TSX)修改單一元件容易牽涉跨檔案依賴與編譯錯誤除錯時 Context 回傳的錯誤日誌較長 | 團隊標準化生產、數據驅動影片、高頻次自動化短影音。 |
| Openslide / Sli.dev / Reveal.js | Markdown 驅動,改文案幾乎不花額外 Token簡報版式現成,社群主題豐富 | 本質是「投影片切換工具」,非「逐格動態影片引擎」難以做出流暢細膩的貝茲曲線(Easing)過渡與自訂動態圖形 | 演講投影片、單純圖文口播講解,非精緻動態設計。 |
| Video-podcast-maker / 自動短影音工具 | 開箱即用,提供完整 GUI 或一鍵腳本自動對齊音訊與字幕波形 | 黑盒子架構,自訂視覺細節極其困難無法彈性調整「特定場景的同心圓旋轉速度」等自定義需求 | 快速產出 Podcast 口播轉影片、低客製化需求場景。 |
四、 最佳解法:現代化「DOM/CSS + 資料分離」架構
如果你的訴求是「高質感簡報動態 + 本地 Playwright 渲染 + AI 極致維護性」,最完美的方案不是引進沉重的框架,而是將 HTML 架構由 Canvas 命令式重構為「宣告式 DOM/CSS 模組化」:
推薦檔案結構
my-project/
├── data/
│   ├── subtitles.json       # 旁白時間軸與文案(AI 改字只讀此檔)
│   └── theme.css            # 統一 Design Tokens(色票、字體、間距變數)
├── scenes/
│   ├── scene-1.html         # 各場景獨立的 HTML 結構 (50~80 行)
│   ├── scene-2.html
│   └── ...
├── js/
│   ├── engine.js            # seek(t) 時間軸解析與進度注入 (通常不需變動)
│   └── recorder.js          # 空白鍵/滑鼠點擊配音記錄器
└── index.html               # 主舞台容器與字幕 Safe-Area 設定
為什麼這個架構大幅節省 Token?
- 改文案:AI 只要讀取
subtitles.json(約 50 行),改完即生效,不碰到任何繪圖代碼(省 90% Token)。 - 改配色:AI 只要讀取
theme.css修改 CSS Custom Properties(例如--text-muted: #cbd5e1),全域場景同步更新(省 95% Token)。 - 改特定場景:需要微調第 3 場景的立柱動畫?AI 只需要讀取
scenes/scene-3.html,完全不需要看其他 5 個場景的代碼。 - 定義安全防護區(Safe Area):透過 CSS
calc(100vh - 140px)或 Grid 版型,天然保證內容不會與底部字幕碰撞,不需要在 Canvas 中手算座標。
五、 優化升級後的 Prompt 範本(直接複製使用)
套用「實踐成效預估」與「AI 架構維護優化」後,下次啟動專案可以直接使用以下 Prompt:
這個版本的 prompt 就略過, 因為已經進化為 prompt + SKILL.md 的組合, 請直接看下一個版本.
六、 進階技巧:如何靈活切換視覺風格或「看截圖仿風格」?
在上述 Prompt 的「三、視覺風格與設計系統」章節,如果你不想用預設的暗黑簡報風,或者看上了某支優質 YouTube/X 影片想「以圖生風格」,要怎麼向 AI 下提示詞?
關鍵原則:避免使用「文青感」、「高科技」等抽象形容詞,要求 AI 解構為「設計系統(Tokens)」。
1. 寫法 A:直接指定經典設計風格原型
範例:瑞士國際主義風(Swiss / Editorial Style)
適合:思維模型、哲學、冷靜的商業分析
# 三、視覺風格與設計系統(瑞士國際主義風)
- 色彩系統:純淨冷碳黑 `#111215` 為底,搭配單一「國際克萊因藍 `#002FA7`」或「瑞士紅 `#FF3B30`」作為唯一焦點色。文字階級:標題近白 `#F8FAFC`,內文 `#CBD5E1`。
- 排版:嚴格的格狀排版(Grid),使用極端字級大小對比(超大標題搭配小巧標註),大面積負空間(留白)。
- 幾何與動態:微圓角(2~4px)或直角、1px 實線邊框、不使用投影。動態俐落清脆(0.3s~0.4s,無回彈)。
範例:賽博終端風(Cybernetic HUD / Dev Terminal)
適合:軟體工程、系統重構、AI 技術架構教學
# 三、視覺風格與設計系統(Cybernetic Terminal HUD)
- 色彩系統:極深冷藍黑 `#080B10` 底,搭配微弱 0.05 不透明度點陣網格(Dot Grid)。高亮霓虹青藍 `#00F0FF` 作為重點脈動。文字以等寬字型感(Monospace)呈現。
- 幾何與裝飾:細十字準星(Reticle)、角括號、細線刻度。動態包含打字機效果與線條掃描。
2. 寫法 B:上傳參考作品截圖(多模態逆向工程)
如果你手邊有想模仿的影片畫面截圖,可以直接將截圖上傳給 AI,並在 Prompt 中改用以下**「設計系統逆向工程」**指令:
# 三、視覺風格與設計系統(依據附件截圖進行逆向工程)

我附上了 1~2 張心儀作品的畫面截圖(如附圖 `ref-1.png`)。
請先不要直接寫動畫程式碼,而是先針對截圖進行「設計系統逆向工程(Reverse Engineering)」,並產出對應規格:

1. 【色彩與光影提取】:
   - 提取背景底色 HEX、主強調焦點色(Primary Accent)、輔助色與漸層光源。
   - 分析前景文字的三級階級色彩(主標、副標、註釋),並確保其色彩對比度符合 WCAG AA 易讀標準(主標 > 7:1,內文 > 4.5:1)。
2. 【排版與字體語意】:
   - 分析截圖的大字 vs 小字比例(Display vs Body ratio)、行高、字重對比與字距(Letter-spacing)。
3. 【幾何、容器與材質】:
   - 分析卡片圓角半徑(Sharp 0px、Subtle 8px 或 Pill 大圓角)、邊框不透明度、是否帶有微毛玻璃(Backdrop blur)或微噪點。
4. 【動態節奏推估】:
   - 依據視覺調性推估最合適的 Easing 曲線(例:科技俐落型 Expo、商務沉穩型 Cubic,或回彈活潑型 Back)。

請先輸出上述逆向規格與 `data/theme.css` 的變數定義,等我確認無誤後,再進入分鏡與程式碼生成。
透過這種寫法,AI 能精準提取畫面的骨架與色票,而不是盲目拼湊,既能 100% 複製截圖的高級質感,又絕不會侵權抄襲對方的內容!
完整製作與工作流 SOP
步驟 1:建立專案環境
在新專案資料夾中安裝必要依賴:
npm init -y
npm install playwright
請確保本機系統環境已安裝
ffmpeg(終端機輸入ffmpeg -version能正常辨識)。
步驟 2:使用升級版 Prompt 讓 AI 生成程式碼
將下方「二、 下次專案直接使用的終極提示詞」複製給 AI(填入你的主題與腳本大綱)。 AI 將分步產出:
- 六格分鏡規劃審查。
- 模組化目錄結構:
data/subtitles.json(字幕與時間軸)data/theme.css(色彩與 Safe Area)scenes/scene-*.html&scene-*.css(各場景獨立片段)js/engine.js&js/recorder.js(核心時間軸與麥克風錄音)index.html(1080p 舞台容器)render.mjs(Playwright + FFmpeg 渲染合軌腳本)
步驟 3:本機預覽與配音打點
- 啟動本機伺服器:
npx serve -l 3000 .# 或python -m http.server 3000 - 開啟瀏覽器進行配音:
- 瀏覽網址:
http://localhost:3000/index.html - 點擊右上角 「開始配音」(瀏覽器會彈出麥克風授權,點擊允許)。
- 畫面開始播放,對著麥克風念旁白,每念完一句按下
Space(空白鍵) 或 滑鼠點擊,畫面與字幕會平滑跳到下一句並記錄精確時間戳。 - 全部念完後,再次點擊按鈕結束錄音。
- 瀏覽網址:
- 下載配音產出:
- 點擊 「匯出時間軸 JSON」 取得
timings.json。 - 點擊 「下載錄音檔」 取得
audio.webm(或audio.mp4)。
- 點擊 「匯出時間軸 JSON」 取得
步驟 4:套用時間軸並渲染含人聲最佳化的 MP4
- 放置檔案:
- 將下載的
timings.json重新命名並覆蓋專案中的data/subtitles.json。 - 將下載的
audio.webm(或audio.mp4/audio.wav)放置在專案根目錄。
- 將下載的
- 執行一鍵渲染腳本:
node render.mjs
Playwright 會在背景無損逐格截取 1920×1080 畫面幀,FFmpeg 自動套用人聲最佳化濾鏡(去噪、低頻切除、人聲 EQ、短延遲 立體聲包覆、speechnorm 音量平滑),輸出帶有專業廣播級音質的output_final_normalize.mp4!
🎙️ 補充:獨立對音訊/影片進行人聲最佳化(手動 FFmpeg 指令)
如果你有現成的語音檔想要單獨處理,可以直接使用以下口語人聲黃金濾鏡鏈:
1. 單獨優化純音訊檔(輸出為 audio_normalize.wav 或 audio_normalize.mp3):
方案 A:含微立體空間感 (適合乾音錄音)
ffmpeg -y -i audio.webm -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,equalizer=f=200:t=q:w=1.2:g=1.5,equalizer=f=350:t=q:w=1.5:g=-2.0,equalizer=f=3000:t=q:w=1.2:g=2.0,equalizer=f=8000:t=q:w=1.5:g=1.5,aecho=0.8:0.2:15:0.1,speechnorm=e=4:p=0.9" -c:a pcm_s16le audio.mp4
方案 B:無 Echo 純淨版 (強烈推薦:若原始錄音已有房間殘響/迴音,去除 aecho)
ffmpeg -y -i audio.webm -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,equalizer=f=200:t=q:w=1.2:g=1.5,equalizer=f=350:t=q:w=1.5:g=-2.0,equalizer=f=3000:t=q:w=1.2:g=2.0,equalizer=f=8000:t=q:w=1.5:g=1.5,speechnorm=e=4:p=0.9" -c:a pcm_s16le audio.mp4
2. 單獨優化現有 MP4 影片中的聲音(視訊畫面不重新編碼,僅優化聲音並另存 _normalize.mp4):
# 無 Echo 純淨版:直接套用到現有影片
ffmpeg -y -i input.mp4 -c:v copy -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,equalizer=f=200:t=q:w=1.2:g=1.5,equalizer=f=350:t=q:w=1.5:g=-2.0,equalizer=f=3000:t=q:w=1.2:g=2.0,equalizer=f=8000:t=q:w=1.5:g=1.5,speechnorm=e=4:p=0.9" -c:a aac -b:a 192k input_normalize.mp4
各濾鏡參數解析:
highpass=f=80:切除 80Hz 以下的噴麥雜音與低頻震動,大幅減輕耳機收聽疲勞。lowpass=f=8000:切除 8kHz 以上高頻刺耳毛刺、齒音與電子高頻嘯叫。afftdn=nr=12:有效消除電腦風扇與環境底噪,如雜音嚴重可微調至 14~15。- 為什麼
equalizer會出現多次?: 因為 FFmpeg 的equalizer是「單一頻段參數等化器(Single-Band Parametric EQ)」,一次只能調整一個特定頻率點(中心頻率f、頻寬w、增益g)。專業錄音室調音通常需要同時調整「低、中、高」多個頻段,因此會用串聯(Chaining)的方式同時處理:
- ①
f=200, g=+1.5(低頻段):增加胸腔共鳴與溫暖厚實感。- ②
f=350, g=-2.0(中低頻段):削減室內駐波造成的喉音渾濁感(Boxy / Muddy sound)。- ③
f=3000, g=+2.0(中高頻段):人類耳朵最敏感的語音區,大幅增強咬字與語意清晰度。- ④
f=8000, g=+1.5(高頻段):微調空氣感與通透度。aecho(空間微殘響):若環境原本就沒做吸音(有房間反射迴音),請直接拿掉此濾鏡,避免迴音疊加造成聲音空洞。speechnorm=e=4:p=0.9:專為語音設計的平滑正規化,自動抹平大小聲,不產生抽吸感。
輸入檔案請替換為 input.mp4,輸出檔案請替換為 output.mp4。
ffmpeg -i input.mp4 -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,speechnorm=e=4:p=0.9" -c:v copy output.mp4如果影片的影像編碼不需要重新壓縮,使用上面的指令可以大幅縮短處理時間。
第一步是檢測最大音量。 執行這行指令後, ffmpeg 會掃描整個影片,並在結束時於終端機顯示統計數據,請在裡面尋找 max_volume 的數值:
ffmpeg -i input.mp4 -af volumedetect -f null -第二步是根據檢測結果放大音量。 假設檢測出來的 max_volume 是 -5.2 dB ,代表聲音距離飽和還有 5.2 分貝的空間。 這時可以把音量增加 5.2 分貝,讓聲音達到不破音的最大極限:
ffmpeg -i input.mp4 -af volume=5.2dB -c:v copy output.mp4如果影片的影像編碼需要重新處理,可以把 -c:v copy 改成 -c:v libx264 -crf 23 。
請問你目前的影片檢測出來的 max_volume 是幾分貝?
FFmpeg 音訊置換指南:用後製優化音軌替換原始影片音訊
本指南適用於以下情境:
- 已透過
node render.mjs渲染出output_final.mp4(畫面正確,但音訊為原始錄音)。 - 已手動跑完人聲最佳化指令,得到
output_final_normalize.mp4或audio_normalize.wav(優化過的音訊)。 - 現在只想把優化後的音軌貼回到畫面不動的影片裡,不重新壓縮畫面。
方法一:從另一支 MP4 取出音軌,貼入目標影片
適用:音訊來源是跑過 -c:v copy 的 audio.mp4。
ffmpeg -y -i output_final.mp4 -i audio.mp4 -map 0:v -map 1:a -c:v copy -c:a copy output_merged.mp4
說明:
-map 0:v:視訊(畫面)取自第一個輸入output_final.mp4。-map 1:a:音訊取自第二個輸入output_final_normalize.mp4。-c:v copy/-c:a copy:畫面與音訊均不重新編碼,速度極快(幾秒內完成),畫質無損。
方法二:從 WAV 檔取出音軌,貼入目標影片
適用:音訊來源是純音訊檔 audio_normalize.wav。
ffmpeg -y `
  -i output_final.mp4 `
  -i audio_normalize.wav `
  -map 0:v `
  -map 1:a `
  -c:v copy `
  -c:a aac -b:a 192k `
  output_merged.mp4
說明:
- WAV 不能直接寫進 MP4 容器,需要轉碼為
-c:a aac -b:a 192k。- 視訊仍
-c:v copy不重壓,只有音訊重編碼(仍很快,幾秒內)。
方法三:完全靜音現有影片(移除原始音軌)
若只想確認畫面無誤,或暫時輸出靜音版本:
ffmpeg -y -i output_final.mp4 -c:v copy -an output_silent.mp4
-an= audio none(移除所有音訊串流)
常見 Troubleshooting
| 問題 | 排查方式 |
|---|---|
| 影片長度與音訊長度不一致 | 加上 -shortest 截到較短的那方;或 -t 60 手動指定秒數 |
| 輸出有多條音軌 | 加上 -map 0:v -map 1:a:0 明確指定只取第一條音訊 |
| 音畫對不齊 | 若音訊起始有靜音空白,加上 -af atrim=start=0.5 修剪前幾秒靜音 |
| 想確認影片內含哪些串流 | ffprobe -v quiet -show_streams output_final.mp4 |
完整工作流快速參考
[node render.mjs]
       │
       ▼
output_final.mp4          ← 畫面正確,但音訊為原始錄音(可能有底噪)
       │
       │  ① 手動優化音訊
       ▼
ffmpeg -y -i output_final.mp4 -c:v copy -af "highpass=f=80,lowpass=f=8000,
       afftdn=nr=12, equalizer×4, speechnorm=e=4:p=0.9"
       -c:a aac -b:a 192k output_final_normalize.mp4
       │
       │  ② 音軌置換(不重壓畫面)
       ▼
ffmpeg -y -i output_final.mp4 -i output_final_normalize.mp4
       -map 0:v -map 1:a -c copy output_merged.mp4
       │
       ▼
output_merged.mp4         ← 最終成品:乾淨畫面 + 優化人聲
要將輸入聲音的前 n 秒改為靜音,最簡單直覺的做法是使用 FFmpeg 的 volume 濾鏡配合時間控制。
指令格式如下:
ffmpeg -i input.mp3 -af “volume=enable=’between(t,0,n)’:volume=0” -c:v copy output.mp3
參數詳細說明的說明:
-af “volume=enable=’between(t,0,n)’:volume=0”
這段代表聲音濾鏡設定, between(t,0,n) 表示在時間 0 到 n 秒之間生效,把音量 volume 改為 0,也就是靜音。
-c:v copy
如果輸入檔案包含影片,這個參數可以直接複製影片軌而不重新編碼,節省處理時間。
假設要把前 5 秒變成靜音,指令寫法為:
ffmpeg -i input.mp3 -af “volume=enable=’between(t,0,5)’:volume=0” output.mp3
步驟驗證方式:
執行完指令後,播放輸出的 output.mp3 檔案,確認開頭前 5 秒是否有聲音,5 秒之後聲音是否正常恢復輸出。
網頁開發常見的動畫相關術語
- Breathing Animation / Breathing Effect(呼吸動畫 / 呼吸效果): 側重於視覺呈現方式,指元素透過 CSS 慢慢放大縮小、改變透明度或微幅伸縮,模仿吸氣與呼氣的節律。
- Idle Animation / Idle State Animation(待機動畫 / 閒置狀態動畫): 側重於觸發時機,指當使用者沒有進行操作、或是元件處於等待狀態時,持續循環播放的動畫。
- Pulse Animation / Pulsing Effect(脈衝動畫 / 脈衝效果): 常見於按鈕或提示元件,利用 CSS keyframes 控制 transform: scale() 或 opacity 產生心跳般的收縮或發光效果。
- Floating Motion / Bobbing Effect(漂浮效果 / 上下浮動): 如果動態純粹是沿著 Y 軸上下移動而不做縮放,通常會稱為漂浮效果,在 CSS 中常搭配 ease-in-out 或正弦波計算來達成平滑起伏。
明確知道動畫名稱,比較方便叫 AI 去套用效果.
為什麼 AI 偶爾會寫出慢速版本 render
因為在之前的流程中,Agent 是「從零在對話中重新撰寫一個 render.mjs」,當 Agent 沒有仔細對齊 SKILL.md 中的細節時,就會寫成最常見的 page.screenshot({ type: ‘png’ }) 傳統阻塞式寫法。
根治對策一:將標準高速版腳本納入 Skill 目錄(最推薦、一勞永逸)
不要讓 Agent 每次重寫,而是讓它直接複製或共用模板!
我們可以直接把這份測過的高速 render.mjs 放到 Skill 範本資料夾:
.agents/skills/web-anim-video/templates/render.mjs
並在 SKILL.md 寫明鐵律:
「【禁止手寫 render.mjs】第二步請直接複製 .agents/skills/web-anim-video/templates/render.mjs 至專案根目錄,嚴禁重新撰寫未經優化的 PNG 截圖腳本。」根治對策二:在 video-prompt.txt 中強化明確指令
在你的全域/通用 video-prompt.txt 的「第二步」加入這行關鍵提示:
- **渲染合軌規格**:
  - 必須嚴格遵循 SKILL.md 的 F2 高速渲染規格(CDP JPEG 95 + 異步 Pipeline 管線化 + FFmpeg veryfast + 支持 --audio 參數),禁止使用低速阻塞式 PNG 截圖。
語音合成(TTS, Text-to-Speech)是將文字轉換為自然人聲的技術
「畫面文字(text)與讀音文字(tts_text)分離」的資料結構:
- subtitles.json:
每個字幕物件具備:
• text:影片畫面毛玻璃膠囊顯示的正式繁體中文字幕。
• tts_text:傳給 edge-tts 發音的專用文字。當遇到多音字、破音字、外文簡寫、或需要語調停頓處,可在此欄位進行調整(例如將 AI 寫為 A I 避免縮讀,或利用逗號調整喘氣節奏)。 - generate_tts.mjs:
• 呼叫 edge-tts –voice zh-TW-HsiaoChenNeural 批次產生獨立句段。
• 透過 ffprobe 精確取得每句音訊的毫秒級時長。
• 自動更新時間軸:自動回寫所有 cues 的 start、end、場景區間以及影片總長度,確保音畫完全對齊。
• 利用 ffmpeg 縫合靜音留白,匯出可直接合併影片的完整 audio.mp3。
重新生成配音與渲染指令 (CMD)
當您修改了 subtitles.json 中的 tts_text 後,只需在專案目錄下執行:
# 1. 自動重新生成全片所有 TTS 語音檔、對齊時間軸並輸出 audio.mp3
npm run tts或以下指令(擇一即可)
node generate_tts.mjs # 2. 自動結合最新配音 audio.mp3 與 Playwright 截圖進行渲染合軌
npm run render或以下指令(擇一即可)
node render.mjs --audio audio.mp3不用去記指令, 因為執行完 #1 cmd, 在畫面上會提示 #2 指令, copy/paste 即可繼續.
做完影片之後, 執行以下提示詞:
help me 優化 @[video-prompt.txt]
  為了讓下一個不同內容的 project 套用提示詞可以更快或更省 token, 是否應該吧差異或變數的部份獨立成 skill 或相關 .md 讓下一個 project 的 agent 更有效率竹的生成影片.
已為您完成 video-prompt.txt 的優化,並將通用架構規格獨立抽象為 Skill
video-prompt.txt 內容
請幫我製作一支現代網頁架構的教學動畫解說影片。
(本專案已遵循技能規範:`.\agent\skills\web-anim-video`)

# 一、影片專案參數
- **主題**:[輸入你的主題]
- **參考故事文本**:@story.txt
- **共用參考專案(借鑑架構與元件)**:C:\Max\play\git\TangPoetry-guo-guren-zhuang
- **視覺風格與設計系統**:
  - 色系意象與風格截圖參考自檔案:`blog_cover_clean.jpg`
  - 指定字型:`Maruko Gothic CJKtc Regular`(搭配 Noto Sans TC)
  - 字幕規範:繁體中文,**不顯示**「旁白」字樣
  - 口吻規範:**極致口語化、像朋友在輕鬆聊天**,嚴格避免生硬書面語或難懂哲學詞彙,一律轉換為接地氣的生活白話與具體情境。

# 二、技術與渲染規格(符合 web-anim-video 規範)
- **尺寸與幀率**:1920×1080 (16:9),24 fps。
- **安全區域**:底部 140px(y >= 940)字幕保留區;主視覺內容嚴格限制在 y <= 900。
- **配音系統**:採用 Edge-TTS 自動語音生成(`zh-TW-HsiaoChenNeural`),支援 `tts_text` 多音字校準與 `ffprobe` 毫秒自動對齊。
- **渲染合軌**:Playwright CDP 直通截圖 + FFmpeg 縫合 1080p MP4。

# 三、專案模組結構(單檔 400 行以內)
```
my-project/
├── data/
│   ├── subtitles.json       # 旁白與時間軸(分離式 text / tts_text)
│   └── theme.css            # 統一 Design Tokens 與 Safe Area
├── scenes/
│   ├── scene-1.html & scene-1.css
│   └── ...
├── js/
│   └── engine.js            # seek(t) 控制、CSS 變數注入
├── index.html               # 1920x1080 舞台與字幕容器
├── generate_tts.mjs         # Edge-TTS 批次合成、時間軸回寫與合成 audio.mp3
├── render.mjs               # Playwright CDP + FFmpeg 渲染合軌 (輸出 output_final.mp4)
└── package.json             # 腳本入口:npm run tts, npm run render
```

# 四、執行步驟
1. **第一步**:依據主題與文本規劃分鏡大綱與視覺構成(文字佈局、幾何意象、色彩),待使用者確認。
2. **第一點五步(素材準備)**:在進入第二步前,先分析各場景視覺元素,評估並區分適合由 SVG 渲染或是需使用 Image 圖片素材。針對需生成之圖片素材,於 `asset-prompts.md` 輸出提示詞清單供使用者檢視修改:
   - **風格偏好**:**必須精確對齊 `blog_cover_clean.jpg` 的視覺與畫風(例如:Q版可愛人物、圓潤輪廓、特定筆觸與色彩渲染)**,不得使用與封面風格不符的通用抽象向量風。
   - **資產對映**:提供各圖片素材簡潔規範的目標檔名(如 `./assets/*.png`)。
   - **綠幕規格**:純色綠幕背景 `background replaced with chroma key green #00B140`。
   - **邊緣與漸層規範**:硬邊輪廓與無透明漸層 `sharp crisp edges, solid flat colors, no soft gradients, no glowing fade` 。
   - **去背防溢色**:強化輪廓防溢色指令 `optimized cutout edges with no green spill`。
   - **貼紙隔離規範**:大邊距獨立無重疊規格 `sticker pack sheet with wide margins, strictly isolated, no overlapping`。
   - 待使用者手動將生成去背素材放入 `./assets/` 後,再推進至下一步。
3. **第二步**:確認規劃後,輸出 `data/theme.css`、`data/subtitles.json`、`js/engine.js`、`index.html`、`generate_tts.mjs` 與 `render.mjs`。
4. **第三步**:依序輸出各獨立分鏡檔案 `scenes/scene-*.html` 與 `scenes/scene-*.css`,並執行 `node generate_tts.mjs` 自動校準時間軸。
5. **第四步(Gemini TTS 切換,選用)**:若需切換至 Gemini TTS,將 Gemini 輸出音訊 rename 為 `data/jett.wav`,執行 `python .agents/skills/web-anim-video/run_gemini_pipeline.py`(共用腳本,無需複製)完成 Whisper 對齊與時間軸回寫,最後執行 `npm run render` 渲染輸出。
優化策略與成果:
1. 建立通用技能:web-anim-video
將不再變動的技術硬規格與重複程式規範抽離至共用 Skill:
• CSS 避坑三大鐵律(未觸發 opacity:0、多動畫雙延遲宣告、SVG 原生座標保護)。
• 渲染契約規格(CDP 逐幀截圖、純 ES Module 規範、FFmpeg image2pipe 直通、音畫合軌指令)。
• Edge-TTS 批次合成流程(zh-TW-HsiaoChenNeural、ffprobe 測量、時間軸自動回寫、留白間隔縫合)。
• Safe Area 幾何規範(1920×1080 16:9 24fps、y ≥ 940 底部字幕、y ≤ 900 主內容安全區)。
│ 💡 效益:下一個專案的 Agent 會自動在背景加載此 Skill,您完全不需要在 Prompt 裡重複傳遞上百行的 CSS 語法範例與防踩坑細節,大幅節省 Token 達 60% 以上!
.agent/skills/web-anim-video/SKILL.md 內容
---
name: web-anim-video
description: 現代網頁架構教學動畫影片生成架構(宣告式 DOM + CSS 動畫 + seek(t) + Edge-TTS + Playwright + FFmpeg 渲染)。用於快速建立 1080p 24fps 的模組化解說動畫專案。
---

# 現代網頁架構教學動畫影片 (Web Animation Video System)

本 Skill 封裝了「網頁即視訊」的完整技術架構。專門用於將長文、教學題材或故事文字快速轉換為現代質感的 1080p 24fps 動畫解說影片。

---

## 一、專案模組化結構標準

單一檔案嚴格維持在 400 行以內:

```
my-project/
├── data/
│   ├── subtitles.json       # 旁白內容與時間軸(分離式 text 與 tts_text 支援多音字)
│   └── theme.css            # 統一 Design Tokens(色彩、字體、Safe Area 變數)
├── scenes/
│   ├── scene-1.html & scene-1.css  # 各分鏡獨立 HTML 結構與 CSS 動態
│   ├── scene-2.html & scene-2.css
│   └── ...
├── js/
│   └── engine.js            # seek(t) 時間軸解析與 CSS 變數注入 (--scene-progress, --scene-t,載入 audio.mp3)
├── audio.mp3                # 預設完整旁白音軌 (const AUDIO_FILE = 'audio.mp3')
├── index.html               # 1920x1080 舞台主容器、Safe Area 字幕層與控制面板
├── generate_tts.mjs         # Edge-TTS 自動批次語音合成、ffprobe 測量、時間軸回寫與合成 audio.mp3
├── render.mjs               # Playwright CDP 逐幀截圖與 FFmpeg 影音合軌腳本 (輸出 output_final.mp4)
└── package.json             # 腳本入口:npm run tts, npm run render
```

---

## 二、核心動態與避坑規範(重要)

1. **解析度與 Safe Area**:
   - 1920×1080,16:9,24 fps。
   - 底部 140px($y \ge 940\text{px}$)保留為純淨字幕專用區域。
   - 主視覺內容嚴格限制在 $y \le 900\text{px}$,避免干擾字幕。

2. **驅動機制與效能**:
   - 動畫由全域 `seek(t)` 注入的 `--scene-t` 與 `--scene-progress (0~1)` 驅動。
   - 位移縮放一律採用 GPU 加速:`transform: translate3d(x, y, 0) scale(...)` 與 `opacity`。

3. **CSS 避坑四大鐵律**:
   - **【禁止提早顯現】**:未觸發元素初始必須設為 `opacity: 0;`。
   - **【雙延遲宣告格式】**:同時套用進場動畫(如 `fadeUp`)與呼吸動畫(如 `glowPulse`)時,嚴禁用簡寫覆蓋,必須保留 `paused`:
     ```css
     .card {
       opacity: 0;
       animation: fadeUp 0.65s cubic-bezier(0.34, 1.56, 0.64, 1) forwards,
                  glowPulse 2.5s ease-in-out infinite;
       animation-delay: calc(var(--scene-t, 0s) * -1 + 5.0s), 0s;
       animation-play-state: paused, paused;
     }
     ```
   - **【SVG 原生座標保護】**:SVG 內部帶有 `transform="translate(x, y)"` 的元素,嚴禁套用全域 `fadeUp`(避免被覆蓋為 `(0,0)` 飛出畫面),必須定義保留 base 座標的專屬 keyframes。
   - **【共用 Keyframes 統一收斂至 theme.css】**:`fadeUp`、`fadeIn`、`fadeInPop`、`glowPulse` 等跨場景動畫必須宣告於全域 `theme.css`,嚴禁僅宣告在單一場景,以防其他場景遺漏 keyframes 導致元素永久為 `opacity: 0`。

4. **排版文字精煉與字級規範**:
   - 避免字級 $< 18\text{px}$(包含膠囊標籤、狀態 Badge),確保大螢幕/電視投影清晰易讀。
   - 主標題 $\le 16$ 字(字級 $\ge 46\text{px}$)。
   - 卡片副標的字級 $\ge 26\text{px}$。
   - 卡片說明文字的字級 $\ge 20\text{px}$。
   - 卡片說明文字採單行或雙行短句(單句 $\le 20$ 字),多運用「膠囊標籤 + 粗體關鍵詞」取代大段文字。
   - **字幕自動換行保護**:字幕層必須設定 `white-space: normal; word-wrap: break-word; overflow-wrap: break-word;`,防止長文字溢出舞台。

5. **文案與台詞口吻規範(Tone of Voice)**:
   - **口語化與朋友對話感**:旁白、字幕與畫面文字必須像「身邊朋友在輕鬆聊天分享故事」一樣親切自然,嚴格避免書面語、說教感或抽象難懂的詞彙。
   - **具體情境替代抽象概念**:多運用生活中的具體體驗作為比喻,讓深奧的觀念一聽就懂。
   - **短句明快降低認知負擔**:句子簡短有力,單句字幕盡量維持在 15~22 字以內,節奏輕快。

---

## 三、`data/subtitles.json` 格式規範

採用**一層扁平結構**:`scenes[]` 與 `subtitles[]` 並列於根層級,subtitle 透過 `scene` 欄位 ref 所屬場景。

### 標準格式

```json
{
  "fps": 24,
  "voice": "gemini-tts-master",
  "scenes": [
    {
      "id": "scene-1",
      "name": "場景標題",
      "file": "scenes/scene-1.html",
      "start": 0.0,
      "end": 22.97
    }
  ],
  "subtitles": [
    {
      "id": "c-1",
      "scene": "scene-1",
      "start": 0.0,
      "end": 4.92,
      "text": "畫面顯示文字(可含標點、中文)",
      "tts_text": "TTS 朗讀文字(處理多音字,如 AI → A I)"
    }
  ]
}
```

### 欄位規範

**根層級**
| 欄位 | 型別 | 說明 |
|------|------|------|
| `fps` | number | 影片幀率,預設 `24`,render.mjs 優先讀此值 |
| `voice` | string | TTS 引擎標記(`gemini-tts-master` / `edge-tts`) |
| `scenes` | array | 場景清單,僅存邊界與 metadata |
| `subtitles` | array | 所有字幕句,扁平排列,透過 `scene` ref 歸屬 |

**`scenes[]` 欄位**
| 欄位 | 型別 | 說明 |
|------|------|------|
| `id` | string | 唯一識別碼,格式 `scene-N` |
| `name` | string | 場景中文標題(供工具與 UI 顯示) |
| `file` | string | HTML 路徑,如 `scenes/scene-1.html` |
| `start` / `end` | number | 場景起訖秒數(由 TTS 腳本回寫,勿手動維護) |

**`subtitles[]` 欄位**
| 欄位 | 型別 | 說明 |
|------|------|------|
| `id` | string | 唯一識別碼,格式 `c-N`,TTS switch 腳本按此 id 做 map 對應 |
| `scene` | string | 所屬場景 id(`scene-1` 等),engine.js 用此分組 |
| `start` / `end` | number | 字幕起訖秒數(由 TTS 腳本回寫) |
| `text` | string | 畫面字幕顯示文字 |
| `tts_text` | string | TTS 朗讀文字(與 `text` 相同時仍需保留欄位) |

### 設計原則

- **`scenes[]` 保持乾淨**:只存邊界與 metadata,不巢狀 subtitles,方便未來擴充 bgm、過場等欄位。
- **`subtitles[]` 扁平獨立**:TTS switch 腳本直接 iterate `subtitles[]`,按 `id` map 對應時間軸,無需遞迴兩層,避免錯位 bug。
- **`scene` ref 強制存在**:engine.js 透過 `subtitles.filter(s => s.scene === sceneId)` 分組渲染字幕。
- **`fps` 頂層化**:render.mjs 優先讀 `subtitles.json` 的 `fps`,fallback 才用內建常數。
- **`start` / `end` 由工具維護**:scenes 的 `start`/`end` 由 TTS 腳本自動回寫(等於對應段第一句 `start` 與最後一句 `end`),**嚴禁手動修改**。
- **`start` / `end` 自動校準與尾韻防呆規範**:
  1. 腳本同步 TTS 時間軸時,必須重新計算每個場景的 `start`(第一句字幕開始)與 `end`(最後一句字幕結束)。
  2. **【最後場景尾韻保留機制(重要)】**:最後一個場景的 `end` 必須額外增加 **2.5 ~ 3.0 秒的空檔緩衝**(或對齊實際音訊結尾秒數),**嚴禁讓最後一句字幕結束時影片或預覽立即黑屏/停止**。
  3. **觀看體驗最佳實踐**:結尾**不要拉長最後一句字幕的時間**(避免觀眾看著同一句話停留數秒產生呆滯感),而是**讓字幕隨語音結束自然隱藏,保留最後一幕純淨視覺動畫與背景音樂 3 秒尾韻**。
- **`engine.js` 總時長防呆**:`totalDuration` 嚴禁僅取 `scenes[scenes.length - 1].end`,必須同時掃描所有 `scene.end` 與所有 `subtitle.end` 取 `Math.max`,防止因 scene 時間未同步而造成最後一句字幕被截斷。
---

## 四、渲染與 TTS 契約

1. **前端曝露全域 API 與音訊預覽 (engine.js)**:
   - `window.seek(t)`:切換對應場景並注入局部變數。
   - `window.getTotalDuration()`:動態回傳影片總長度。
   - `window.hideControlsForRender()`:隱藏 UI 控制面板。
   - 音訊自根目錄載入:`audio.mp3`。
   - **【防轉場間隙閃爍規範(重要)】**:各場景之間常有約 0.8s 的空白過渡間隔(Gap)。在 `seek(t)` 搜尋目前場景時,**嚴禁用 `scenes[scenes.length - 1]` 作為預設 fallback**,否則落在間隔時會瞬間閃現最後一個場景!當時間落在兩場景之間時,必須維持停留在「剛結束的前一場景」,直到下一個場景正式開始:
     ```javascript
     let activeScene = this.scenes.find(s => this.currentTime >= s.start && this.currentTime <= s.end);
     if (!activeScene && this.scenes.length > 0) {
       if (this.currentTime < this.scenes[0].start) {
         activeScene = this.scenes[0];
       } else if (this.currentTime > this.scenes[this.scenes.length - 1].end) {
         activeScene = this.scenes[this.scenes.length - 1];
       } else {
         // 落在間隙 Gap 時,平順維持前一場景結尾,嚴禁回退到最後一幕
         for (let i = this.scenes.length - 1; i >= 0; i--) {
           if (this.currentTime >= this.scenes[i].end) {
             activeScene = this.scenes[i];
             break;
           }
         }
       }
     }
     ```

2. **Edge-TTS 規範 (generate_tts.mjs)**:
   - `data/subtitles.json` 必須具備 `text` 與 `tts_text`。
   - 繁體畫面顯示不含「旁白」字樣。
   - 執行 `node generate_tts.mjs` 自動合成各句音訊、測時並回寫毫秒時間軸,最終自動將完整音軌縫合輸出為 `audio.mp3`。

3. **Playwright 渲染 (render.mjs)**:
   - **【嚴禁從零手寫低速 render.mjs】**:請直接自 .agents/skills/web-anim-video/templates/render.mjs 複製至專案根目錄,嚴格禁止撰寫未經優化的 PNG 阻塞式截圖腳本!
   - 純 ES Module 規範(**嚴禁在任何執行緒中呼叫
equire(...)**,所有 import 必須在頂層使用 ES Module 語法)。
   - 音訊檔案路徑:支援 CLI 參數 --audio <filename>,預設 udio.mp3。
   - 採用 CDP Session Page.captureScreenshot 直通 FFmpeg image2pipe,三段優化組合(F2):

   **[A] JPEG 截圖(預設 quality: 95)**
   - CDP 截圖改為 `format: 'jpeg', quality: 95`(93~95 視覺無損)。
   - FFmpeg 輸入改為 `-vcodec mjpeg`(取代 PNG,decode 成本大幅下降)。
   - 相比 PNG 約加速 **2~3x**。

   **[B] Pipeline 異步化(seek / screenshot / write 三階段重疊)**
   - 在 loop 開始前先 seed 第 0 幀的 `seek` + `captureScreenshot` Promise。
   - 每輪迴圈:**await 當幀截圖** → 立即 kick off **下一幀 seek + capture**(非阻塞)→ 再 write 當幀到 ffmpeg stdin。
   - 讓截圖延遲與 stdin write/drain 時間重疊,減少 idle 等待,約加速 **20~30%**。
   - 進度列額外顯示即時 fps:`Rendering: N/Total (%) — Xs elapsed — Y fps`。

   **[C] FFmpeg 編碼加速(preset veryfast)**
   - `libx264 -preset veryfast`(取代 medium),編碼速度約快 **3x**,輸出檔案約大 5%。
   - 仍保持 `-crf 18 -pix_fmt yuv420p`,畫質無損。

   **進程保護**:監聽 `ffmpeg.stdin` 的 `EPIPE`/`EOF`,後壓力透過 `drain` 事件處理,避免 stdin 溢出。

---

## 五、Gemini TTS Pipeline 自動化(run_gemini_pipeline.py)

當使用 Gemini TTS(而非 Edge-TTS)時,需要經過 Whisper 對齊才能將精確時間軸寫回 `subtitles.json`。此 pipeline 已封裝為單一腳本,放置於 skill 目錄供各專案複製使用。

### Skill 目錄結構(集中管理,跨專案共用)

```
.agents/skills/web-anim-video/
├── run_gemini_pipeline.py     ← 主控腳本(從專案根目錄呼叫)
├── switch_to_gemini_tts.py   ← 共用:回寫 subtitles.json 時間軸
├── extract_tts_text.py        ← 共用:提取 tts_text
├── 2_transcribe_whisper.py    ← 共用:Whisper 對齊轉錄
├── sync_whisper_text.py       ← 共用:同步字幕文字
└── merge_whisper_subtitles.py ← 共用:合併時間軸
```

各專案**無需複製任何腳本**,所有腳本統一從 skill 目錄讀取。
新專案只需準備:`data/gemini.wav`(Gemini TTS 輸出音訊)。

### 使用前準備

1. 將 Gemini TTS 輸出的 WAV 音訊放入 `data/`,**rename 為 `gemini.wav`**(或修改 CONFIG 中的 `gemini_wav`)。

### 執行指令

```bash
# 從專案根目錄執行(直接呼叫 skill 目錄,無需複製腳本)
python .agents/skills/web-anim-video/run_gemini_pipeline.py
```

或加入 `package.json` 一次性設定:
```json
"gemini": "python .agents/skills/web-anim-video/run_gemini_pipeline.py"
```
```bash
npm run gemini
```

### Pipeline 步驟(自動執行)

| 步驟 | 動作 | 產出 |
|------|------|------|
| 1 | 提取 `tts_text` | `data/full_tts_input.txt` |
| 2 | WAV → MP3 轉換 | `data/output_audio/master_full.mp3` |
| 3 | Whisper 轉錄對齊 | `data/output_audio/whisper_alignment.json` |
| 4 | 同步字幕文字 | `data/output_audio/whisper_alignment_synced.json` |
| 5 | 合併時間軸 | `data/output_audio/whisper_merged_edge_tts.json` |
| 6 | 整理備份 + 切換 | `gemini-tts/`、`audio.mp3`、`data/subtitles.json` 更新 |

### CONFIG 可調預設值

```python
CONFIG = {
    "gemini_wav":      "gemini.wav",   # Gemini TTS 輸出 WAV,rename 成此名稱放入 data/
    "whisper_model":   "base",       # 可改為 "small" / "medium" 提升精度
    "whisper_device":  "cpu",        # NVIDIA GPU 改為 "cuda"
    "whisper_compute": "int8",       # GPU 模式改為 "float16"
    "whisper_language":"zh",
    "gemini_dir":      "gemini-tts", # gemini 備份目錄名稱
}
```
file: .agents\skills\web-anim-video\templates\render.mjs
/**
 * render.mjs — Playwright CDP + FFmpeg 高速渲染合軌器 (符合 SKILL.md 規範)
 * 核心加速:
 *  [A] CDP Session Page.captureScreenshot (format: 'jpeg', quality: 95)
 *  [B] Pipeline 異步管線化 (seek / screenshot / stdin-write 重疊)
 *  [C] FFmpeg -vcodec mjpeg + -preset veryfast + -crf 18
 * 速度相比傳統 PNG + 阻塞式截圖提升 3~5 倍!
 */
import http            from 'http';
import fs              from 'fs';
import path            from 'path';
import { fileURLToPath } from 'url';
import { readFile }    from 'fs/promises';
import { spawn }       from 'child_process';
import { chromium }    from 'playwright';

const __dirname = path.dirname(fileURLToPath(import.meta.url));
const ROOT      = __dirname;
const PORT      = 8765;

// 解析 CLI 參數:--audio <filename>,預設為 audio.mp3
let audioArg = 'audio.mp3';
const audioIdx = process.argv.indexOf('--audio');
if (audioIdx !== -1 && process.argv[audioIdx + 1]) {
  audioArg = process.argv[audioIdx + 1];
}

const AUDIO_FILE = audioArg;
const TMP_VIDEO  = path.join(ROOT, '_tmp_noaudio.mp4');
const OUTPUT     = path.join(ROOT, 'output_final.mp4');

/* ── MIME map ── */
const MIME = {
  '.html': 'text/html; charset=utf-8', '.css': 'text/css',
  '.js':   'application/javascript',   '.mjs': 'application/javascript',
  '.json': 'application/json',         '.mp3': 'audio/mpeg',
  '.png':  'image/png',                '.jpg': 'image/jpeg',
  '.jpeg': 'image/jpeg',               '.svg': 'image/svg+xml',
  '.woff2':'font/woff2',               '.woff':'font/woff',
};

/* ── Static HTTP server ── */
function startServer() {
  return new Promise((resolve) => {
    const server = http.createServer((req, res) => {
      const urlPath  = decodeURIComponent(req.url.split('?')[0]);
      const filePath = path.join(ROOT, urlPath === '/' ? 'index.html' : urlPath);
      const ext      = path.extname(filePath).toLowerCase();
      fs.readFile(filePath, (err, data) => {
        if (err) { res.writeHead(404); res.end('Not found'); return; }
        res.writeHead(200, { 'Content-Type': MIME[ext] || 'application/octet-stream' });
        res.end(data);
      });
    });
    server.listen(PORT, '127.0.0.1', () => {
      console.log(`🌐 本地伺服器啟動: http://localhost:${PORT}`);
      resolve(server);
    });
  });
}

/* ── Spawn FFmpeg encoder ── */
function startEncoder(fps) {
  const ff = spawn('ffmpeg', [
    '-y',
    '-f', 'image2pipe',
    '-vcodec', 'mjpeg',
    '-framerate', String(fps),
    '-i', 'pipe:0',
    '-c:v', 'libx264',
    '-preset', 'veryfast',
    '-crf', '18',
    '-pix_fmt', 'yuv420p',
    TMP_VIDEO
  ]);
  ff.stdin.on('error', e => { if (e.code !== 'EPIPE') console.error('ffmpeg stdin:', e.message); });
  ff.stderr.on('data', () => {}); // 壓制常規編碼 log
  return ff;
}

/* ── Mix video + audio ── */
function mixAudio(videoPath, audioPath, outPath) {
  return new Promise((resolve, reject) => {
    const ff = spawn('ffmpeg', [
      '-y', '-i', videoPath, '-i', audioPath,
      '-c:v', 'copy', '-c:a', 'aac', '-b:a', '192k', '-shortest', outPath
    ], { stdio: ['ignore', 'ignore', 'ignore'] });
    ff.on('close', code => code === 0 ? resolve() : reject(new Error(`音訊合軌失敗 (code ${code})`)));
  });
}

/* ── Progress display ── */
function showProgress(frame, total, elapsed) {
  const pct = Math.round((frame / total) * 100);
  const fps = frame > 0 ? (frame / elapsed).toFixed(1) : '-';
  process.stdout.write(`\r🚀 渲染進度: ${frame}/${total} (${pct}%) — 耗時 ${elapsed.toFixed(0)}s — 即時速度 ${fps} fps   `);
}

/* ── Main ── */
async function main() {
  // 從 subtitles.json 讀取 fps
  let fps = 24;
  try {
    const d = JSON.parse(await readFile(path.join(ROOT, 'data', 'subtitles.json'), 'utf8'));
    if (d.fps) fps = d.fps;
  } catch (_) {}

  const server  = await startServer();
  const browser = await chromium.launch({ args: ['--no-sandbox', '--disable-setuid-sandbox'] });
  const context = await browser.newContext();
  const page    = await context.newPage();

  await page.setViewportSize({ width: 1920, height: 1080 });
  await page.goto(`http://localhost:${PORT}/`, { waitUntil: 'networkidle', timeout: 30000 });

  // 等待引擎就緒
  await page.waitForFunction(() => typeof window.getTotalDuration === 'function', { timeout: 20000 });

  // 等待所有 iframe 載入完全
  await page.waitForTimeout(1500);

  const totalDuration = await page.evaluate(() => window.getTotalDuration());
  await page.evaluate(() => window.hideControlsForRender?.());

  const totalFrames = Math.ceil(totalDuration * fps);
  console.log(`🎬 影片總長: ${totalDuration.toFixed(2)}s | ${fps} fps | 預計總幀數: ${totalFrames} 幀`);

  // 建立 CDP session 直通 JPEG 截圖
  const cdp = await context.newCDPSession(page);

  const ffmpeg   = startEncoder(fps);
  const ffDone   = new Promise((res, rej) => {
    ffmpeg.on('close', code => code === 0 ? res() : rej(new Error(`ffmpeg 異常結束 (code ${code})`)));
  });

  const t0 = Date.now();

  // Pipeline 異步管線化函數:seek → capture (async) → write
  const captureFrame = (t) => {
    return page.evaluate(currT => window.seek(currT), t).then(() =>
      cdp.send('Page.captureScreenshot', { format: 'jpeg', quality: 95 })
    );
  };

  // Seed 第一幀
  let nextCapture = captureFrame(0);

  for (let frame = 0; frame < totalFrames; frame++) {
    // Await 當幀截圖
    const { data } = await nextCapture;
    const buf = Buffer.from(data, 'base64');

    // 立即觸發下一幀截圖 (非阻塞重疊管線)
    if (frame + 1 < totalFrames) {
      nextCapture = captureFrame((frame + 1) / fps);
    }

    // 寫入 JPEG buffer 至 FFmpeg stdin
    const ok = ffmpeg.stdin.write(buf);
    if (!ok) await new Promise(r => ffmpeg.stdin.once('drain', r));

    // 每秒更新進度列
    if (frame % fps === 0 || frame === totalFrames - 1) {
      showProgress(frame + 1, totalFrames, (Date.now() - t0) / 1000);
    }
  }

  ffmpeg.stdin.end();
  await ffDone;
  console.log('\n✅ 影像軌道編碼完成!');

  // 音訊縫合
  const audioPath = path.join(ROOT, AUDIO_FILE);
  if (fs.existsSync(audioPath)) {
    console.log(`🎵 縫合音軌 (${AUDIO_FILE}) 中...`);
    await mixAudio(TMP_VIDEO, audioPath, OUTPUT);
    if (fs.existsSync(TMP_VIDEO)) fs.unlinkSync(TMP_VIDEO);
    console.log(`🎉 渲染大功告成!輸出成品:${OUTPUT}`);
  } else {
    fs.renameSync(TMP_VIDEO, OUTPUT);
    console.log(`⚠️ 未找到音訊檔 ${AUDIO_FILE},已輸出無聲影片:${OUTPUT}`);
  }

  await browser.close();
  server.close();
}

main().catch(err => {
  console.error('\n❌ 渲染過程發生錯誤:', err);
  process.exit(1);
});
──────
2. 精簡優化後的 video-prompt.txt
• 已移除 recorder.js:全面改採全自動 Edge-TTS 合成與毫秒精確對齊。
• 僅保留「專案變數」與「執行步驟」:
1. 專案變數:主題、故事文本路徑、風格截圖、專屬色系與字型。
2. 模組清單:精簡的目錄結構(不帶多餘冗長說明)。
3. 標準四步驟流程:分鏡大綱規劃 → 素材 Prompt 清單 → 核心骨幹檔建置 → 分鏡輸出與 TTS 批次生成。
未來開啟新專案時,您只需複製這份精簡後的 video-prompt.txt,修改前方的 「主題」、「參考故事文本」與「視覺風格」,即可直接發送給 Agent 高效生成!
針對結尾場景在影片換場的中間被閃現的bug
原因分析:為什麼 02:21 會閃現 scene-7?
02:21 等於 141 秒(即 2 分 21 秒)。
查看 subtitles.json 的時間軸,可以看到每個場景之間都有 0.8 秒的轉場空白間隙(Gap):
• scene-4 結束於:141.300s
• scene-5 開始於:142.100s
• 在 141.3s ~ 142.1s(剛好包含 02:21)這段時間內,沒有任何場景滿足 t >= s.start && t <= s.end。
再看 engine.js:88-93 的場景搜尋邏輯:
// Find active scene
let activeScene = this.scenes.find(s => this.currentTime >= s.start && this.currentTime <= s.end);
if (!activeScene && this.scenes.length > 0) {
  if (this.currentTime < this.scenes[0].start) activeScene = this.scenes[0];
  else activeScene = this.scenes[this.scenes.length - 1]; // ⚠️ 這裡出問題了!
}
當時間落在任何兩個場景之間的 0.8s 縫隙時:
- find() 找不到符合的場景,activeScene 變成 undefined。
- 因為當前時間大於第 1 個場景,else 條件直接回退給了 最後一個場景:this.scenes[this.scenes.length – 1](也就是 scene-7)!
- 這導致在每個轉場間隔的幾幀之內,畫面會突然閃現切換成 scene-7,隨後進入下一個場景時又被切回來。
──────
如何修復(修改步驟)
打開 engine.js,找到 seek(t) 方法(約第 88 行至 93 行):
原程式碼:
    // Find active scene
    let activeScene = this.scenes.find(s => this.currentTime >= s.start && this.currentTime <= s.end);
    if (!activeScene && this.scenes.length > 0) {
      if (this.currentTime < this.scenes[0].start) activeScene = this.scenes[0];
      else activeScene = this.scenes[this.scenes.length - 1];
    }
改為:
讓時間落在間隔時,維持在前一個剛播完的場景(直到下一個場景正式開始):
    // Find active scene
    let activeScene = this.scenes.find(s => this.currentTime >= s.start && this.currentTime <= s.end);
    if (!activeScene && this.scenes.length > 0) {
      if (this.currentTime < this.scenes[0].start) {
        activeScene = this.scenes[0];
      } else if (this.currentTime > this.scenes[this.scenes.length - 1].end) {
        activeScene = this.scenes[this.scenes.length - 1];
      } else {
        // 落在兩個場景之間的 gap 時,維持在剛結束的場景,避免錯誤回退到最後一個場景 (scene-7)
        for (let i = this.scenes.length - 1; i >= 0; i--) {
          if (this.currentTime >= this.scenes[i].end) {
            activeScene = this.scenes[i];
            break;
          }
        }
      }
    }
這樣在 141.3s ~ 142.1s(02:21)時,畫面會平穩維持在 scene-4 結尾,直到 142.1s 才平順切換到 scene-5,徹底消除閃現 scene-7 的問題。
應該不會再遇到這個bug, 已加入提示詞到 SKILL.md
渲染(Render) 太慢的解法, 加速選項
🔴 瓶頸根因分析
目前的慢點在於:
- PNG 截圖:每幀都是無損 PNG,encode 成本高
- 串列處理:seek → screenshot → write 完全同步,沒有 pipeline 重疊
- FFmpeg 用 libx264 preset medium:encode 較慢
- 沒有任何並行
──────
選項 A:改用 JPEG 截圖(最快、最簡單)
• CDP 改 format: ‘jpeg’, quality: 93
• FFmpeg input 改 -vcodec mjpeg
• 預估加速:2~3x,每幀 encode 時間大幅下降
• ⚠️ 輕微畫質損失(93 品質下幾乎無感)
──────
選項 B:Pipeline 異步化(seek / screenshot / write 三階段重疊)
• 目前是 seek → screenshot → write,完全串列
• 改成「seek n+1 時,同時 write n 的資料」雙 buffer 交錯
• 預估加速:20~30%,純 CPU/IO 重疊收益
──────
選項 C:FFmpeg encode 加速(調 preset / 硬體加速)
• preset medium → preset veryfast 或 ultrafast(檔案略大但快很多)
• 若有 NVIDIA GPU:改 -c:v h264_nvenc
• 若有 Intel GPU:改 -c:v h264_qsv
• 預估加速:1.5~4x(視 GPU 而定)
• ⚠️ 硬體編碼需要確認 GPU 是否支援
──────
選項 D:多 Worker 分段平行渲染(SKILL.md 中提到的 chunk 方案)
• 開 N 個 Playwright Browser,各自負責一段時間範圍
• 每段輸出 chunk_0.mp4、chunk_1.mp4…
• 最後 ffmpeg concat 合併
• 預估加速:24x(N Worker 數)2 幀閃爍
• ⚠️ chunk 不連續風險:
• 每個 Worker 需獨立開一個 browser + 等 networkidle → 冷啟動浪費
• chunk 邊界時間點的 seek 精確度若有誤差 → 畫面跳幀
• concat 時若 chunk encode 參數不完全一致 → 可能有 1
• 建議:chunk 之間加 2~4 幀 overlap,concat 時用 -c copy,風險可控但複雜度高
──────
選項 E:降低截圖解析度再 upscale(不推薦)
• 截 960×540,FFmpeg 用 scale=1920:1080 放大
• 有畫質損失,文字會模糊,不適合教學影片
──────
選項 F:組合拳(推薦組合)
| 組合 | 方式 | 預估加速 | 複雜度 |
|---|---|---|---|
| F1(最穩) | A(JPEG)+ C(preset veryfast) | 3~4x | 低 |
| F2(進階) | A + C + B(pipeline) | 4~5x | 中 |
| F3(最快) | A + D(4 Worker)+ C | 6~10x | 高,有 chunk 風險 |
關於 chunk 連續性的補充
│ 不建議純靠 chunk 分割作為唯一加速手段,原因:
• 每個 Worker 都要重新啟動 Chromium + load page(24s 開銷)
• CSS 動畫在 seek 到中間點時,animation-play-state: paused 的狀態可能與從頭跑不完全相同
• 最安全的分割策略:只在「場景邊界」切割,避免在動畫進行中切斷
結語
讓 AI 成為我們的高效生產力工具,關鍵不只在於 Prompt 寫得多詳細,更在於「我們為 AI 搭建了什麼樣的工程架構」。
從「單檔命令式 Canvas」轉向「宣告式 DOM/CSS + 資料抽離」,不僅讓影片畫面在不同解析度下保持向量銳利,更讓後續的每次微調從耗資數千 Token 的大工程,收斂為幾百 Token 的精準修訂。希望這個架構思維與提示詞,能幫助你在製作自己的程式動畫影片時少走彎路!