近年來,「用程式碼寫動畫,再透過 Playwright 逐格截圖渲染成 4K/60fps 影片(Code-to-Video)」的工作流逐漸成為獨立創作者與工程師的熱門利器。搭配 Cursor、Claude、ChatGPT 或 Antigravity 等 AI 程式助理,只要給出大綱與腳本,AI 幾分鐘就能為你寫出一個包含時間軸控制、字幕對位與動畫渲染的網頁。
但在實際反覆迭代、微調設計風格時,很多人會遇到一個痛點:「為什麼我只是想改場景 3 的文字顏色,或者把某個元素往上移 20px,AI 卻花費了天量的 Token,甚至因為上下文過長開始遺漏程式碼?」
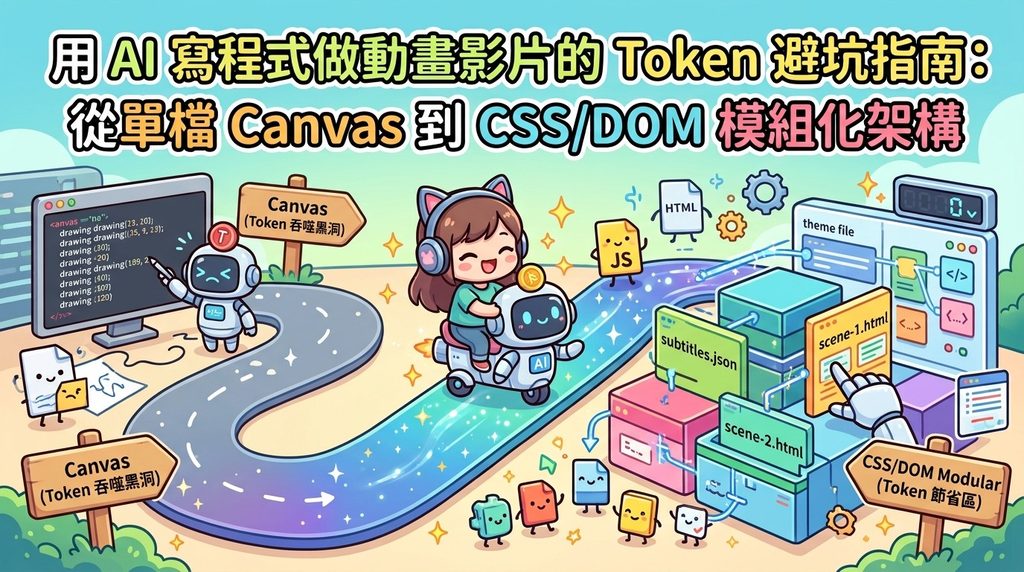
本文將以真實專案經驗為出發點,分析這個「Token 吞噬黑洞」的成因,提供第三方動畫框架的完整選型評估,並給出優化後的最佳實踐架構與升級版 Prompt 範本。
一、 血淚經驗:原本的工作流與 Prompt
在製作一支主題為《別拿未來的焦慮,懲罰現在還在努力的自己》的教學動畫時,我們最初給 AI 的 Prompt 如下:
原版 Prompt
幫我製作一支教學動畫解說影片,主題是「別拿未來的焦慮,懲罰現在還在努力的自己」。
用程式逐格渲染成 MP4(HTML Canvas 的 seek(t) + Playwright 截圖 + ffmpeg),並用我的聲音配旁白。

# 一、規格
- 16:9,1920×1080,30 fps,旁白參考 file:@code-v10.md
- 字幕在畫面下方,深色膠囊底、象牙白字;字幕顯示原文(英文、數字照寫)
- 不加背景音樂;旁白會由我真人配音, 下一段字幕的顯示的觸發是按 mouse click or keyword space key.
- 直接隱藏面, 讓我可以直接錄畫面同時配音產生影片, 並要支援我使用 click or space 切換 subtitle.

# 二、旁白稿(8 段,畫面以段落為單位)
1. 段落清單:
- 別拿未來的焦慮,懲罰現在還在努力的自己。
- 一個關於焦慮的小故事
- 修好性格,成為靠得住的人
- 練好本事,別成為破水桶
- 停止內耗,掌控不了的交給上天
- 做完你能做的,剩下的就別煩惱了
- 歡迎留言分享:你最近最想卸下的內耗是什麼呢?
2. 先不要寫程式,給我六格分鏡。讓我看過、改過最後確認過,等方向對了再動手。
3. 顯示風格為 dark theme 有高級質感的簡報風格的動畫, 避免太花俏的用色, 每個場景之間要有一致性.
  目標受眾為一般民眾, 避免於 dark theme 使用太暗的前景文字, 會造成閱讀困難.
4. 渲染之前,先抽開頭、中間、結尾三格檢查,沒問題再整支輸出。
5. 避免最下面的字幕overwrite 畫面顯示的元素, 字幕上緣約在 y≈940,使所有元素都在 y≤870 以內,留有約 70px 安全距離。
二、 為什麼這個工作流程會變成「Token 吞噬黑洞」?
當 AI 依照上述提示詞生成檔案時,通常會產出一個 單一且龐大的 scene.html(長達 1,200 ~ 1,500 行),裡頭包含:
- CSS Reset 與控制面板樣式
- 預設的旁白時間軸陣列
- Playwright 逐格渲染輔助鉤子
- 錄音模式與快捷鍵邏輯
- 龐大的 Canvas 2D 命令式繪圖代碼(
drawScene1到drawScene6)
核心問題剖析:
- 單檔肥大(Monolithic File)
AI 助理每執行一次修改(例如「把文字調亮」),工具必須把這 1,300+ 行程式碼送入 Context Window。若經過 4~5 輪微調,單次對話就消耗了數萬甚至數十萬 Tokens。 - 命令式(Imperative)Canvas 繪圖對 AI 極不友善
Canvas 是像素與命令導向的:ctx.fillStyle = "rgba(148,163,184,0.7)"; ctx.fillText("能力不足,機會留不住", x, y + 200);文字、顏色、排版全寫死在 JS 運算中。當你要調整邊界或對比度時,AI 無法透過 CSS 選擇器全域修改,必須逐行用正則搜尋每條指令並手工計算座標(如y - 280 + i * 60),極易出錯且耗損算力。 - 資料、樣式、邏輯三者混雜
旁白文案、色票(Design Tokens)、場景布局和時間軸驅動全部混在一起。改動文案等於改動動態繪圖代碼。
三、 第三方框架選型評估
在決定下一步架構前,我們針對市面上常見的動畫與影片生成方案進行了深入評估:
| 方案 | 特色與優勢 | 缺點 / AI 維護成本 | 適合場景 |
|---|---|---|---|
| 原生 DOM/CSS 模組化 (強烈推薦) | 0 第三方依賴,極速啟動直接保留既有的 Playwright + ffmpeg 渲染工作流支援 CSS 變數,修改全域樣式極度省 Token宣告式 HTML/CSS,AI 解析與修改代碼成功率最高 | 不適合極其繁複的三維流體或物理碰撞粒子運算 | 首選推薦:文字講解、高級商務簡報、Motion Graphic 圖表動畫。 |
| Remotion (React) | 業界最成熟的 Code-based 影片框架支援 React 元件生態與強大的時間軸(useCurrentFrame)伺服器端確定性渲染優秀 | 專案初始化門檻高(Node.js, Webpack, TSX)修改單一元件容易牽涉跨檔案依賴與編譯錯誤除錯時 Context 回傳的錯誤日誌較長 | 團隊標準化生產、數據驅動影片、高頻次自動化短影音。 |
| Openslide / Sli.dev / Reveal.js | Markdown 驅動,改文案幾乎不花額外 Token簡報版式現成,社群主題豐富 | 本質是「投影片切換工具」,非「逐格動態影片引擎」難以做出流暢細膩的貝茲曲線(Easing)過渡與自訂動態圖形 | 演講投影片、單純圖文口播講解,非精緻動態設計。 |
| Video-podcast-maker / 自動短影音工具 | 開箱即用,提供完整 GUI 或一鍵腳本自動對齊音訊與字幕波形 | 黑盒子架構,自訂視覺細節極其困難無法彈性調整「特定場景的同心圓旋轉速度」等自定義需求 | 快速產出 Podcast 口播轉影片、低客製化需求場景。 |
四、 最佳解法:現代化「DOM/CSS + 資料分離」架構
如果你的訴求是「高質感簡報動態 + 本地 Playwright 渲染 + AI 極致維護性」,最完美的方案不是引進沉重的框架,而是將 HTML 架構由 Canvas 命令式重構為「宣告式 DOM/CSS 模組化」:
推薦檔案結構
my-project/
├── data/
│   ├── subtitles.json       # 旁白時間軸與文案(AI 改字只讀此檔)
│   └── theme.css            # 統一 Design Tokens(色票、字體、間距變數)
├── scenes/
│   ├── scene-1.html         # 各場景獨立的 HTML 結構 (50~80 行)
│   ├── scene-2.html
│   └── ...
├── js/
│   ├── engine.js            # seek(t) 時間軸解析與進度注入 (通常不需變動)
│   └── recorder.js          # 空白鍵/滑鼠點擊配音記錄器
└── index.html               # 主舞台容器與字幕 Safe-Area 設定
為什麼這個架構大幅節省 Token?
- 改文案:AI 只要讀取
subtitles.json(約 50 行),改完即生效,不碰到任何繪圖代碼(省 90% Token)。 - 改配色:AI 只要讀取
theme.css修改 CSS Custom Properties(例如--text-muted: #cbd5e1),全域場景同步更新(省 95% Token)。 - 改特定場景:需要微調第 3 場景的立柱動畫?AI 只需要讀取
scenes/scene-3.html,完全不需要看其他 5 個場景的代碼。 - 定義安全防護區(Safe Area):透過 CSS
calc(100vh - 140px)或 Grid 版型,天然保證內容不會與底部字幕碰撞,不需要在 Canvas 中手算座標。
五、 優化升級後的 Prompt 範本(直接複製使用)
套用「實踐成效預估」與「AI 架構維護優化」後,下次啟動專案可以直接使用以下 Prompt:
幫我製作一支教學動畫解說影片。
主題:【請在此替換你的影片主題,例如:別拿未來的焦慮,懲罰現在還在努力的自己】
技術規格:採用「宣告式 DOM + CSS 動畫 + 獨立模組化」的現代網頁架構,支援即時麥克風配音打點,並透過 seek(t) + Playwright 截圖 + FFmpeg 渲染成含音訊的 1080p MP4。

# 一、架構規範(關注點分離與 Token 最優化)
嚴禁產出超過 300 行的單一巨大檔案,嚴格遵守模組化結構:
my-project/
├── data/
│   ├── subtitles.json       # 旁白資料與打點時間軸(AI 改文案僅需讀寫此檔)
│   └── theme.css            # 統一 Design Tokens(色票、字體、Safe Area 變數)
├── scenes/
│   ├── scene-1.html & scene-1.css  # 各場景獨立的 HTML 結構與 CSS 動態 (50~80行)
│   ├── scene-2.html & scene-2.css
│   └── ...
├── js/
│   ├── engine.js            # seek(t) 時間軸解析與 CSS 變數注入 (--scene-progress)
│   └── recorder.js          # 空白鍵/滑鼠打點控制器 + MediaRecorder 麥克風錄音器
├── index.html               # 1920x1080 舞台主容器、Safe Area 與控制面板
└── render.mjs               # Playwright 逐格截圖 + FFmpeg 影音合軌腳本

# 二、詳細技術規格
1. 畫面與動態:
   - 16:9,1920×1080,30 fps。
   - 底部 140px 嚴格劃為字幕防護區(Safe Area),主要視覺內容容器限制在 y <= 870,保證絕不遮擋字幕。
   - 動態以 CSS Transitions / Transforms 為主,由全域 seek(t) 注入 `--scene-progress (0~1)` 驅動。
2. 配音與收音系統(js/recorder.js):
   - 點擊「開始配音」即自動請求麥克風 `navigator.mediaDevices.getUserMedia` 並啟動 `MediaRecorder`。
   - 按下 `Space` 或滑鼠點擊切換下一句字幕,記錄精確的 `start` / `end` 時間戳至陣列。
   - 錄音結束後提供「匯出時間軸 JSON(timings.json)」與「下載錄音檔(audio.webm 或 audio.mp4)」按鈕。
   - 提供快捷鍵 `H` 隱藏/展開控制面板。

3. 嚴格鎖定渲染合約(Render Contract & render.mjs 實作標準):
   為確保跨 AI 模型輸出的一致性,網頁與 render.mjs 遵守以下 API 契約,嚴禁更改渲染流程:
   - 【前端必須暴露的 3 個全域 API】:
     1. `window.seek = (t) => { ... }`:精確跳轉至 t 秒(浮點數),切換對應場景並注入 `--scene-progress`。
     2. `window.getTotalDuration = () => number`:回傳影片總秒數(依據 subtitles 結尾時間)。
     3. `window.hideControlsForRender = () => { ... }`:隱藏控制面板與進度條,為 `#viewport` 留下純淨畫面。
   - 【render.mjs 的標準實作限制(嚴禁生成變形做法)】:
     - 必須啟動 Playwright 無頭瀏覽器(viewport: 1920x1080),訪問 `http://127.0.0.1:3000/index.html`。
     - 總幀數計算:`Math.ceil(totalDuration * fps)`。
     - 影格截圖目標:嚴格鎖定容器 `page.$('#viewport')`。
     - 音畫自動混音(原音直通):
       - FFmpeg 自動偵測根目錄是否存在 `audio.webm` / `audio.mp4` / `audio.wav` / `audio.mp3`。
       - 若存在音訊,以 `-i audio.* -c:a aac -b:a 192k` 直接合軌(保持原音直通,不自動掛載音訊濾鏡,避免聲音被二次過度處理)。
     - 編碼參數標準:`-c:v libx264 -pix_fmt yuv420p -preset fast -crf 18 output_final.mp4`。

# 三、視覺風格與設計系統(Design System)
- 風格:高級質感 Dark Theme 知識簡報風(以深藍黑 #0a0d14 為底,搭配暖琥珀金色作為焦點色,冷岩灰做輔助)。
- 對比度嚴格遵循 WCAG AA:標題近白 #f8fafc,內文為高對比的 #cbd5e1 或 #94a3b8,避免於深色底使用太暗的文字造成閱讀障礙。
- 字幕:居中深色毛玻璃膠囊底,象牙白字,字級約 32px。

# 四、腳本大綱與段落
【在此貼上你的旁白稿與大綱,例如:】
- 段落 1:破題,點出核心痛點
- 段落 2:故事案例與認知誤區
- 段落 3:核心方法第一層
- 段落 4:核心方法第二層
- 段落 5:核心方法第三層
- 段落 6:總結歸納與互動留言

# 五、執行步驟(請依序進行,不要一次性輸出過多代碼)
1. 第一步:先輸出各分鏡的視覺構成規劃(文字佈局、核心幾何圖像、配色意象),讓我審查並確認方向。
2. 第二步:確認後,輸出 `data/theme.css`、`data/subtitles.json`、`js/engine.js`、`js/recorder.js`、`index.html` 與 `render.mjs`。
3. 第三步:依序輸出各個獨立分鏡 `scenes/scene-*.html` 與 `scenes/scene-*.css`。
六、 進階技巧:如何靈活切換視覺風格或「看截圖仿風格」?
在上述 Prompt 的「三、視覺風格與設計系統」章節,如果你不想用預設的暗黑簡報風,或者看上了某支優質 YouTube/X 影片想「以圖生風格」,要怎麼向 AI 下提示詞?
關鍵原則:避免使用「文青感」、「高科技」等抽象形容詞,要求 AI 解構為「設計系統(Tokens)」。
1. 寫法 A:直接指定經典設計風格原型
範例:瑞士國際主義風(Swiss / Editorial Style)
適合:思維模型、哲學、冷靜的商業分析
# 三、視覺風格與設計系統(瑞士國際主義風)
- 色彩系統:純淨冷碳黑 `#111215` 為底,搭配單一「國際克萊因藍 `#002FA7`」或「瑞士紅 `#FF3B30`」作為唯一焦點色。文字階級:標題近白 `#F8FAFC`,內文 `#CBD5E1`。
- 排版:嚴格的格狀排版(Grid),使用極端字級大小對比(超大標題搭配小巧標註),大面積負空間(留白)。
- 幾何與動態:微圓角(2~4px)或直角、1px 實線邊框、不使用投影。動態俐落清脆(0.3s~0.4s,無回彈)。
範例:賽博終端風(Cybernetic HUD / Dev Terminal)
適合:軟體工程、系統重構、AI 技術架構教學
# 三、視覺風格與設計系統(Cybernetic Terminal HUD)
- 色彩系統:極深冷藍黑 `#080B10` 底,搭配微弱 0.05 不透明度點陣網格(Dot Grid)。高亮霓虹青藍 `#00F0FF` 作為重點脈動。文字以等寬字型感(Monospace)呈現。
- 幾何與裝飾:細十字準星(Reticle)、角括號、細線刻度。動態包含打字機效果與線條掃描。
2. 寫法 B:上傳參考作品截圖(多模態逆向工程)
如果你手邊有想模仿的影片畫面截圖,可以直接將截圖上傳給 AI,並在 Prompt 中改用以下**「設計系統逆向工程」**指令:
# 三、視覺風格與設計系統(依據附件截圖進行逆向工程)

我附上了 1~2 張心儀作品的畫面截圖(如附圖 `ref-1.png`)。
請先不要直接寫動畫程式碼,而是先針對截圖進行「設計系統逆向工程(Reverse Engineering)」,並產出對應規格:

1. 【色彩與光影提取】:
   - 提取背景底色 HEX、主強調焦點色(Primary Accent)、輔助色與漸層光源。
   - 分析前景文字的三級階級色彩(主標、副標、註釋),並確保其色彩對比度符合 WCAG AA 易讀標準(主標 > 7:1,內文 > 4.5:1)。
2. 【排版與字體語意】:
   - 分析截圖的大字 vs 小字比例(Display vs Body ratio)、行高、字重對比與字距(Letter-spacing)。
3. 【幾何、容器與材質】:
   - 分析卡片圓角半徑(Sharp 0px、Subtle 8px 或 Pill 大圓角)、邊框不透明度、是否帶有微毛玻璃(Backdrop blur)或微噪點。
4. 【動態節奏推估】:
   - 依據視覺調性推估最合適的 Easing 曲線(例:科技俐落型 Expo、商務沉穩型 Cubic,或回彈活潑型 Back)。

請先輸出上述逆向規格與 `data/theme.css` 的變數定義,等我確認無誤後,再進入分鏡與程式碼生成。
透過這種寫法,AI 能精準提取畫面的骨架與色票,而不是盲目拼湊,既能 100% 複製截圖的高級質感,又絕不會侵權抄襲對方的內容!
完整製作與工作流 SOP
步驟 1:建立專案環境
在新專案資料夾中安裝必要依賴:
npm init -y
npm install playwright
請確保本機系統環境已安裝
ffmpeg(終端機輸入ffmpeg -version能正常辨識)。
步驟 2:使用升級版 Prompt 讓 AI 生成程式碼
將下方「二、 下次專案直接使用的終極提示詞」複製給 AI(填入你的主題與腳本大綱)。 AI 將分步產出:
- 六格分鏡規劃審查。
- 模組化目錄結構:
data/subtitles.json(字幕與時間軸)data/theme.css(色彩與 Safe Area)scenes/scene-*.html&scene-*.css(各場景獨立片段)js/engine.js&js/recorder.js(核心時間軸與麥克風錄音)index.html(1080p 舞台容器)render.mjs(Playwright + FFmpeg 渲染合軌腳本)
步驟 3:本機預覽與配音打點
- 啟動本機伺服器:
npx serve -l 3000 . # 或 python -m http.server 3000 - 開啟瀏覽器進行配音:
- 瀏覽網址:
http://localhost:3000/index.html - 點擊右上角 「開始配音」(瀏覽器會彈出麥克風授權,點擊允許)。
- 畫面開始播放,對著麥克風念旁白,每念完一句按下
Space(空白鍵) 或 滑鼠點擊,畫面與字幕會平滑跳到下一句並記錄精確時間戳。 - 全部念完後,再次點擊按鈕結束錄音。
- 瀏覽網址:
- 下載配音產出:
- 點擊 「匯出時間軸 JSON」 取得
timings.json。 - 點擊 「下載錄音檔」 取得
audio.webm(或audio.mp4)。
- 點擊 「匯出時間軸 JSON」 取得
步驟 4:套用時間軸並渲染含人聲最佳化的 MP4
- 放置檔案:
- 將下載的
timings.json重新命名並覆蓋專案中的data/subtitles.json。 - 將下載的
audio.webm(或audio.mp4/audio.wav)放置在專案根目錄。
- 將下載的
- 執行一鍵渲染腳本:
node render.mjsPlaywright 會在背景無損逐格截取 1920×1080 畫面幀,FFmpeg 自動套用人聲最佳化濾鏡(去噪、低頻切除、人聲 EQ、短延遲 立體聲包覆、speechnorm 音量平滑),輸出帶有專業廣播級音質的output_final_normalize.mp4!
🎙️ 補充:獨立對音訊/影片進行人聲最佳化(手動 FFmpeg 指令)
如果你有現成的語音檔想要單獨處理,可以直接使用以下口語人聲黃金濾鏡鏈:
1. 單獨優化純音訊檔(輸出為 audio_normalize.wav 或 audio_normalize.mp3):
# 方案 A:含微立體空間感 (適合乾音錄音)
ffmpeg -y -i audio.webm -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,equalizer=f=200:t=q:w=1.2:g=1.5,equalizer=f=350:t=q:w=1.5:g=-2.0,equalizer=f=3000:t=q:w=1.2:g=2.0,equalizer=f=8000:t=q:w=1.5:g=1.5,aecho=0.8:0.3:20:0.2,speechnorm=e=4:p=0.9" -c:a pcm_s16le audio_normalize.wav

# 方案 B:無 Echo 純淨版 (強烈推薦:若原始錄音已有房間殘響/迴音,去除 aecho)
ffmpeg -y -i audio.webm -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,equalizer=f=200:t=q:w=1.2:g=1.5,equalizer=f=350:t=q:w=1.5:g=-2.0,equalizer=f=3000:t=q:w=1.2:g=2.0,equalizer=f=8000:t=q:w=1.5:g=1.5,speechnorm=e=4:p=0.9" -c:a pcm_s16le audio_normalize.wav
2. 單獨優化現有 MP4 影片中的聲音(視訊畫面不重新編碼,僅優化聲音並另存 _normalize.mp4):
# 無 Echo 純淨版:直接套用到現有影片
ffmpeg -y -i input.mp4 -c:v copy -af "highpass=f=80,lowpass=f=8000,afftdn=nr=12,equalizer=f=200:t=q:w=1.2:g=1.5,equalizer=f=350:t=q:w=1.5:g=-2.0,equalizer=f=3000:t=q:w=1.2:g=2.0,equalizer=f=8000:t=q:w=1.5:g=1.5,speechnorm=e=4:p=0.9" -c:a aac -b:a 192k input_normalize.mp4
各濾鏡參數解析:
highpass=f=80:切除 80Hz 以下的噴麥雜音與低頻震動,大幅減輕耳機收聽疲勞。lowpass=f=8000:切除 8kHz 以上高頻刺耳毛刺、齒音與電子高頻嘯叫。afftdn=nr=12:有效消除電腦風扇與環境底噪,如雜音嚴重可微調至 14~15。- 為什麼
equalizer會出現多次?: 因為 FFmpeg 的equalizer是「單一頻段參數等化器(Single-Band Parametric EQ)」,一次只能調整一個特定頻率點(中心頻率f、頻寬w、增益g)。專業錄音室調音通常需要同時調整「低、中、高」多個頻段,因此會用串聯(Chaining)的方式同時處理:
- ①
f=200, g=+1.5(低頻段):增加胸腔共鳴與溫暖厚實感。- ②
f=350, g=-2.0(中低頻段):削減室內駐波造成的喉音渾濁感(Boxy / Muddy sound)。- ③
f=3000, g=+2.0(中高頻段):人類耳朵最敏感的語音區,大幅增強咬字與語意清晰度。- ④
f=8000, g=+1.5(高頻段):微調空氣感與通透度。aecho(空間微殘響):若環境原本就沒做吸音(有房間反射迴音),請直接拿掉此濾鏡,避免迴音疊加造成聲音空洞。speechnorm=e=4:p=0.9:專為語音設計的平滑正規化,自動抹平大小聲,不產生抽吸感。
FFmpeg 音訊置換指南:用後製優化音軌替換原始影片音訊
本指南適用於以下情境:
- 已透過
node render.mjs渲染出output_final.mp4(畫面正確,但音訊為原始錄音)。 - 已手動跑完人聲最佳化指令,得到
output_final_normalize.mp4或audio_normalize.wav(優化過的音訊)。 - 現在只想把優化後的音軌貼回到畫面不動的影片裡,不重新壓縮畫面。
方法一:從另一支 MP4 取出音軌,貼入目標影片
適用:音訊來源是跑過 -c:v copy 的 output_final_normalize.mp4。
ffmpeg -y `
  -i output_final.mp4 `
  -i output_final_normalize.mp4 `
  -map 0:v `
  -map 1:a `
  -c:v copy `
  -c:a copy `
  output_merged.mp4
說明:
-map 0:v:視訊(畫面)取自第一個輸入output_final.mp4。-map 1:a:音訊取自第二個輸入output_final_normalize.mp4。-c:v copy/-c:a copy:畫面與音訊均不重新編碼,速度極快(幾秒內完成),畫質無損。
方法二:從 WAV 檔取出音軌,貼入目標影片
適用:音訊來源是純音訊檔 audio_normalize.wav。
ffmpeg -y `
  -i output_final.mp4 `
  -i audio_normalize.wav `
  -map 0:v `
  -map 1:a `
  -c:v copy `
  -c:a aac -b:a 192k `
  output_merged.mp4
說明:
- WAV 不能直接寫進 MP4 容器,需要轉碼為
-c:a aac -b:a 192k。- 視訊仍
-c:v copy不重壓,只有音訊重編碼(仍很快,幾秒內)。
方法三:完全靜音現有影片(移除原始音軌)
若只想確認畫面無誤,或暫時輸出靜音版本:
ffmpeg -y -i output_final.mp4 -c:v copy -an output_silent.mp4
-an= audio none(移除所有音訊串流)
常見 Troubleshooting
| 問題 | 排查方式 |
|---|---|
| 影片長度與音訊長度不一致 | 加上 -shortest 截到較短的那方;或 -t 60 手動指定秒數 |
| 輸出有多條音軌 | 加上 -map 0:v -map 1:a:0 明確指定只取第一條音訊 |
| 音畫對不齊 | 若音訊起始有靜音空白,加上 -af atrim=start=0.5 修剪前幾秒靜音 |
| 想確認影片內含哪些串流 | ffprobe -v quiet -show_streams output_final.mp4 |
完整工作流快速參考
[node render.mjs]
       │
       ▼
output_final.mp4          ← 畫面正確,但音訊為原始錄音(可能有底噪)
       │
       │  ① 手動優化音訊
       ▼
ffmpeg -y -i output_final.mp4 -c:v copy -af "highpass=f=80,lowpass=f=8000,
       afftdn=nr=12, equalizer×4, speechnorm=e=4:p=0.9"
       -c:a aac -b:a 192k output_final_normalize.mp4
       │
       │  ② 音軌置換(不重壓畫面)
       ▼
ffmpeg -y -i output_final.mp4 -i output_final_normalize.mp4
       -map 0:v -map 1:a -c copy output_merged.mp4
       │
       ▼
output_merged.mp4         ← 最終成品:乾淨畫面 + 優化人聲
結語
讓 AI 成為我們的高效生產力工具,關鍵不只在於 Prompt 寫得多詳細,更在於「我們為 AI 搭建了什麼樣的工程架構」。
從「單檔命令式 Canvas」轉向「宣告式 DOM/CSS + 資料抽離」,不僅讓影片畫面在不同解析度下保持向量銳利,更讓後續的每次微調從耗資數千 Token 的大工程,收斂為幾百 Token 的精準修訂。希望這個架構思維與提示詞,能幫助你在製作自己的程式動畫影片時少走彎路!